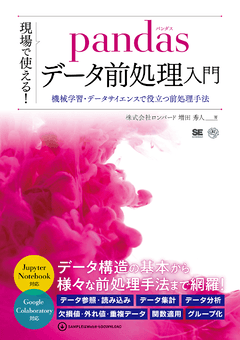
現場で使える!pandasデータ前処理入門 機械学習・データサイエンスで役立つ前処理手法


- 形式:
- 書籍
- 発売日:
- 2020年04月20日
- ISBN:
- 9784798160672
- 定価:
- 4,180円(本体3,800円+税10%)
- 仕様:
- A5・688ページ
- カテゴリ:
- 人工知能・機械学習
- キーワード:
- #プログラミング,#開発手法,#データ・データベース,#ビジネスIT
- シリーズ:
- AI & TECHNOLOGY
 翔泳社通販SEshop
 Kindle
 honto
 ヨドバシ
 BookLive!
 Google


機械学習エンジニア&データサイエンティスト必携!
初学者でもpandasによる前処理手法がわかる
【本書の背景】
機械学習やデータサイエンスでは、いかに「きれいなデータ」を用意できるかが非常に重要です。データクレンジングともいわれますが、実際の現場のデータは、機械学習やデータ分析にすぐ利用できるデータは皆無に等しく、エンジニアによりデータの前処理が必須となってきています。
【本書の概要】
本書は、機械学習やデータサイエンスの現場では、データ処理に必要な定番のライブラリ「pandas」を用いて、前処理の基本と様々な前処理手法について、あますところなく解説した書籍です。
初学者向けにシンプルでわかりやすいサンプルを用いていますので、pandasの基本操作方法やデータ構造、さらに前処理の基本の理解についてもしっかり学ぶことができます。
pandasを理解することで、様々な機械学習・データ分析タスクがスムーズに行えるようになります。
【本書の対象読者】
・機械学習エンジニア(初学者)
・データサイエンティスト(初学者)
【著書からひとこと】
機械学習では「Garbage In, Garbage Out(略、GIGO)」と言う概念があります。これは「無意味な(ゴミのような)データを入力すると無意味な結果が戻される」の意味です。
GIGOの概念でも解る通り、機械学習エンジニアは様々な手法で収集された膨大なデータの分析を行い、意味のある結果を得るために、多種多様な手法の前処理/分析を行います。
機械学習において約7割の時間はデータの前処理に費やされると言われていますが、その多くは「pandas」を使ったものです。
CSVファイルの読み込みから始まり、要約統計量や欠損値・外れ値・重複データの確認、さらにデータのマージやグループ化などの様々なタスクをpandasで行います。
本書では機械学習「初学者向け」にpandasの基本的な操作を解説しています。初歩的な要約統計量の算出やグループ化やダミー変数、さらに文字列や時系列データの基本操作など、幅広い範囲をカバーしています。
日々、データを業務で取り扱う機械学習エンジニアやKaggle等のデータ分析競技をやられている方に向けて、pandasを使ったデータ前処理のお役に立てばと思い執筆いたしました。
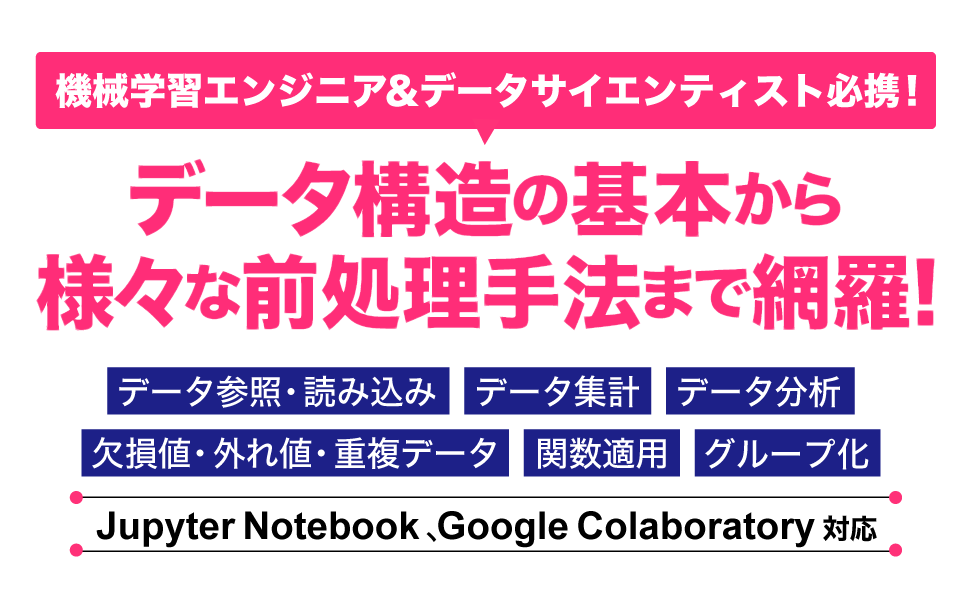
機械学習エンジニア&データサイエンティスト必携!初学者でもpandasによる前処理手法がわかる。
本書は「pandas」を用いて、前処理の基本について、あますところなく解説した書籍です。初学者向けにシンプルでわかりやすいサンプルを用いていますので、pandasの基本操作方法やデータ構造、さらに前処理の基本の理解についてもしっかり学ぶことができます。pandasを理解することで、様々な機械学習・データ分析タスクがスムーズに行えるようになります。
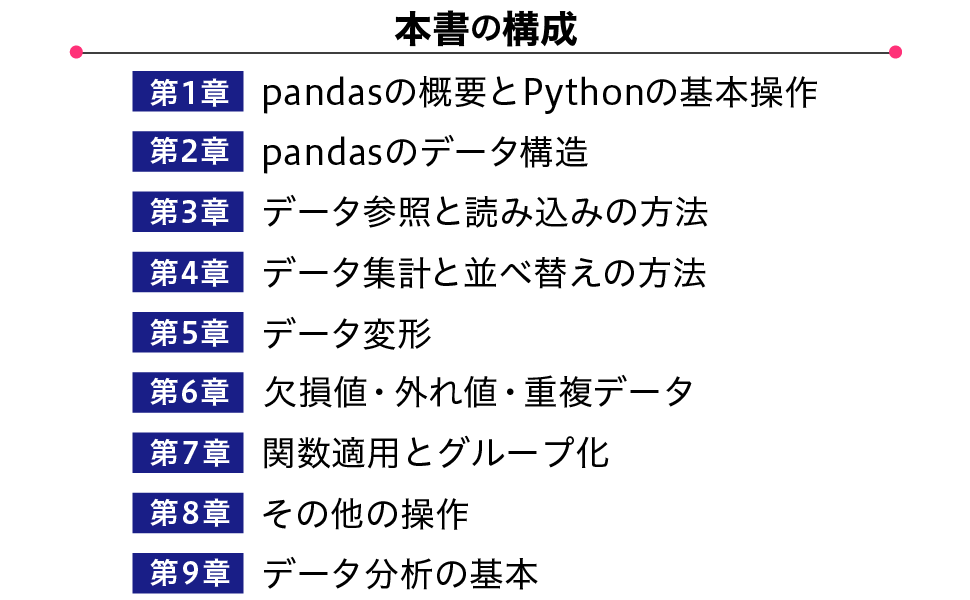
Chapter 1 pandasの概要とPythonの基本操作
1.1 機械学習の分野でなくてはならないライブラリ「pandas」
1.2 pandasを利用する環境の構築
1.3 Pythonのデータ構造
1.4 Pythonの基本操作
1.5 Jupyter Notebookの基本操作
Chapter 2 pandasのデータ構造
2.1 シリーズ
2.2 データフレーム
2.3 インデックス
2.4 pandasを触ってみよう
Chapter 3 データ参照と読み込み
3.1 データ参照
3.2 ファイルの読み込み・書き出し
Chapter 4 データ集計と並べ替え
4.1 データ集計
4.2 データ並べ替え
Chapter 5 データ変形
5.1 追加と削除
5.2 データ連結とマージ
5.3 その他のデータ変形
Chapter 6 欠損値・外れ値・重複データ
6.1 欠損値
6.2 外れ値
6.3 重複データ
Chapter 7 関数適用とグループ化
7.1 関数処理
7.2 for文によるループ処理
7.3 データのグループ化
Chapter 8 その他の操作
8.1 文字列操作
8.2 データの可視化
8.3 階層型インデックス
8.4 時系列データ
Chapter 9 データ分析の基本
9.1 探索的データ解析(EDA)
9.2 整然データ(Tidy Data)
9.3 データ分析の実例(Bank Marketing)
9.4 データ分析の実例(Online Retail Data Set)
書籍の購入や、商用利用・教育利用を検討されている法人のお客様はこちら
図書館での貸し出しに関するお問い合わせはよくあるお問い合わせをご確認ください。
利用許諾に関するお問い合わせ
本書の書影(表紙画像)をご利用になりたい場合は書影許諾申請フォームから申請をお願いいたします。
書影(表紙画像)以外のご利用については、こちらからお問い合わせください。
お問い合わせ
内容についてのお問い合わせは、正誤表、追加情報をご確認後に、お送りいただくようお願いいたします。
正誤表、追加情報に掲載されていない書籍内容へのお問い合わせや
その他書籍に関するお問い合わせは、書籍のお問い合わせフォームからお送りください。
現在表示されている正誤表の対象書籍
書籍の種類:紙書籍
書籍の刷数:全刷
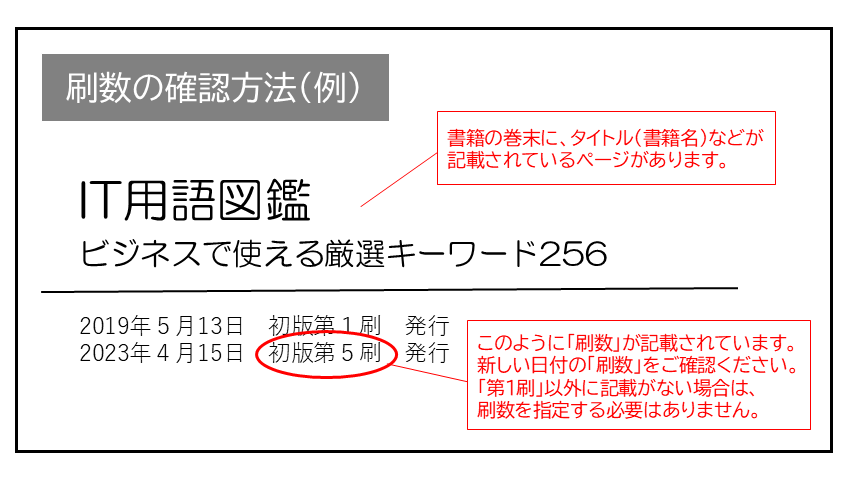
書籍によっては表記が異なる場合がございます
本書に誤りまたは不十分な記述がありました。下記のとおり訂正し、お詫び申し上げます。
対象の書籍は正誤表がありません。
| ページ数 | 内容 | 書籍修正刷 | 電子書籍訂正 | 発生刷 | 登録日 | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 004 ページ全体 |
|
2刷 | 済 | 1刷 | 2020.11.10 | ||||||
| 139 本文上から4行目(リストの行除く) |
|
3刷 | 済 | 1刷 | 2020.11.20 | ||||||
| 424 表7.1のキャプション |
|
3刷 | 済 | 1刷 | 2021.11.25 | ||||||
| 457 本文上から3行目 |
|
3刷 | 済 | 1刷 | 2020.08.07 | ||||||
| 532 リスト8.118のキャプション |
|
3刷 | 済 | 1刷 | 2021.11.25 |
感想・レビュー 
畠山 大有 さん
2021-10-06
pandas の関数の解説本。データ前処理のノウハウについての記述は少ない。最終章に微量がある程度。 私にとってコンピューター関連の本は、ページ数の割には読む時間は早い…
ais さん
2021-01-31
pandasの基本的な使い方を把握できたと思う。これからは辞書感覚で使う。
.png)


