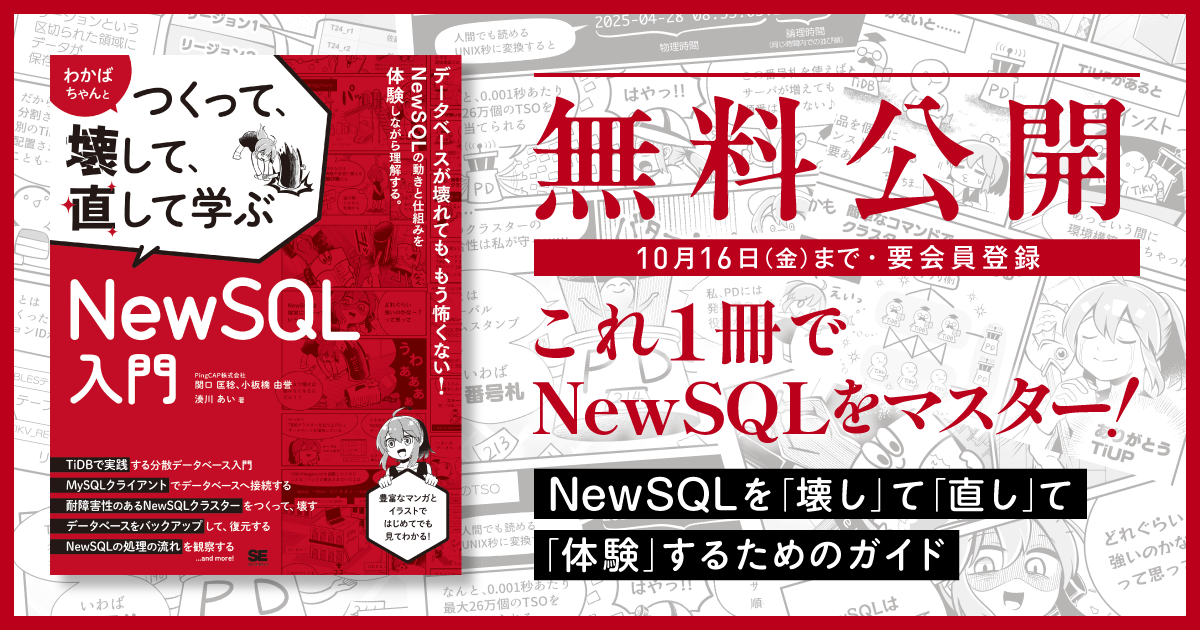
深層学習教科書 ディープラーニング E資格(エンジニア)精選問題集
- 形式:
- 電子書籍
- 発売日:
- 2024年10月30日
- ISBN:
- 9784798180663
- 価格:
- 6,600円(本体6,000円+税10%)
- カテゴリ:
- ベンダー資格
- キーワード:
- #IT関連資格,#情報処理技術者試験,#開発環境,#システム運用
- レーベル:
- EXAMPRESS
- シリーズ:
- 深層学習教科書
購入はこちら
 Kindle
 ヨドバシ
 楽天Kobo
 BookLive!
 honto
 Google
 翔泳社通販SEshop


「E2024#2」試験から適用される新シラバスに完全対応!
〈本書の特長〉
●受講生の高い試験合格率を誇る講師陣の合格メソッドに基づいた、精選問題集。
●E2024#2以降の試験に対応した、唯一の問題集!
●良質な重要問題282問と解説を収録。
⇒出題範囲が広いE資格の中で優先して押さえるべき重要な論点をマスターできる。
●出題範囲を幅広くカバーした「総合問題」1回分をダウンロード提供。
⇒学習を終えた後に、復習や力だめしができる。
●読者特典として、本書の内容に完全対応した「AI読者アシスタント」付き!
⇒難解な用語や問題・解説に関する質問に、瞬時に回答してくれる!
〈監修〉
●岩澤有祐(いわさわ・ゆうすけ)
東京大学大学院工学系研究科准教授。2017年東京大学大学院工学系研究科技術経営戦略学専攻博士後期課程修了。博士(工学)、修士(情報理工学)。『深層学習』(KADOKAWA)共訳。
〈著者〉
●小林範久(こばやし・のりひさ)
株式会社Present Square 最高技術責任者(CTO)。
早稲田大学大学院修了。AI技術を活用したシステムサービスの開発やAI導入のコンサルティングに従事。東京大学松尾・岩澤研究室輪読会会員。
●小林寛幸(こばやし・ひろゆき)
株式会社Present Square 創業者/最高経営責任者(CEO)。
慶應義塾大学大学院修了。経営、事業企画及びAIを含む教育・コンサルティングに従事。社外取締役、非常勤講師等を歴任。東京大学AI経営寄付講座修了(2022)。
〈編者〉
●株式会社Present Square
日本ディープラーニング協会(JDLA)より認定を受けたエンジニア育成講座『DeepSquare』(認定No.00016)、AI動画像解析『Smart Counter-スマカチ-』等のサービスを提供。E資格、G検定、Generative AI Test等の専門資格を保有するコンサルタント及びエンジニアが、初学者から実務者向けの講義、PoC、サービス開発を支援。
<目次>
第1章:数学的基礎
第2章:機械学習
第3章:深層学習の基礎
第4章:深層学習の応用
第5章:開発・運用環境
Web提供:総合問題
※本電子書籍は同名出版物を底本として作成しました。記載内容は印刷出版当時のものです。
※印刷出版再現のため電子書籍としては不要な情報を含んでいる場合があります。
※印刷出版とは異なる表記・表現の場合があります。予めご了承ください。
※プレビューにてお手持ちの電子端末での表示状態をご確認の上、商品をお買い求めください。
(翔泳社)


書籍の購入や、商用利用・教育利用を検討されている法人のお客様はこちら
図書館での貸し出しに関するお問い合わせはよくあるお問い合わせをご確認ください。
利用許諾に関するお問い合わせ
本書の書影(表紙画像)をご利用になりたい場合は書影許諾申請フォームから申請をお願いいたします。
書影(表紙画像)以外のご利用については、こちらからお問い合わせください。
お問い合わせ
内容についてのお問い合わせは、正誤表、追加情報をご確認後に、お送りいただくようお願いいたします。
正誤表、追加情報に掲載されていない書籍内容へのお問い合わせや
その他書籍に関するお問い合わせは、書籍のお問い合わせフォームからお送りください。
-
よくある質問
①第3章大問2小問2の解答はDではなくBではないか?
ご指摘の通り、正しい解答は以下のとおり、Bとなります。
本書の誤りによりご迷惑をおかけし、誠に申し訳ございません。
-----------------------------------------
p.84:第3章大問2小問2正答
<誤>
正答:D. 多クラス分類は、訓練データのラベルをone-hotベクトルで表す。また、出力層にソフトマックス関数を用いて、クロスエントロピー誤差を最小化する。
<正>
正答:B. 多クラス分類は、訓練データのラベルを0または1の整数値で表す。また、出力層にシグモイド関数を用いて、バイナリクロスエントロピー誤差を最小化する。
p.86(上から3行目)
<誤>
よって、正解はD.となります。
<正>
よって、正解はB.となります。
-----------------------------------------
②第3章大問2小問2の解答が「B.」である理由について
小問2の問題は、「最も不適切な選択肢」を選ぶ設問です。Bは、ラベルの表現、出力層の活性化関数、誤差関数のすべてが不適切です。
A.出力層の活性化関数、誤差関数が一般的ではありません。技術的には可能です。
B.ラベルの表現、出力層の活性化関数、誤差関数のすべてが不適切です。技術的にも不適切です。
C.ラベルの表現が一般的ではありません。技術的には可能です。
D.ラベルの表現、出力層の活性化関数、誤差関数のすべてが適切です。
現在表示されている正誤表の対象書籍
書籍の種類:電子書籍
書籍の刷数:全刷
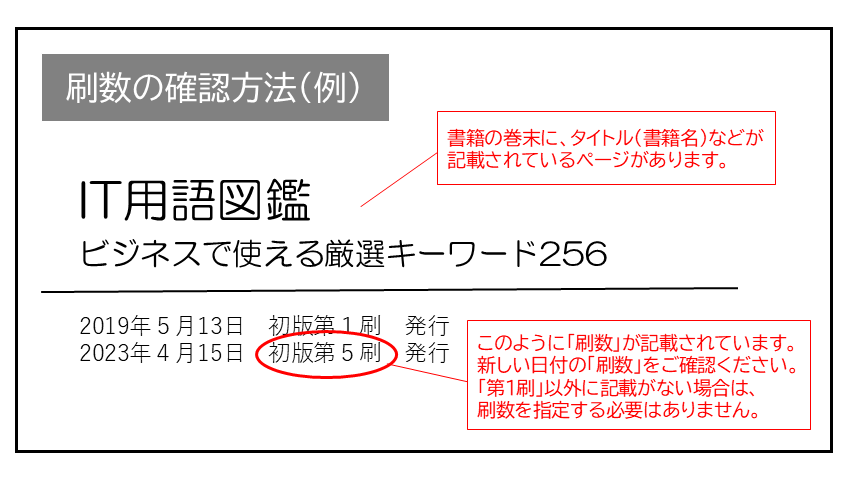
書籍によっては表記が異なる場合がございます
本書に誤りまたは不十分な記述がありました。下記のとおり訂正し、お詫び申し上げます。
対象の書籍は正誤表がありません。
| ページ数 | 内容 | 書籍修正刷 | 電子書籍訂正 | 発生刷 | 登録日 | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 007 「ベイズ則を用いた計算方法」1つ目の数式 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 007 「ベイズ則を用いた計算方法」2つ目の数式 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 012 下から2行目の数式 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 019 「●条件付きエントロピー」内1つ目の数式の右辺1行目・2行目 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 019 「●条件付きエントロピー」上から8行目(2つ目の数式右辺の2行目) |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 020 「●結合エントロピー」内の数式右辺:上から3-4行目 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 025 小問3の上から2.3行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 038 「ここがポイント」2行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 038 「コサイン距離」2行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 038 「コサイン距離」3行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 038 「マハラノビス距離」上から3-6行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 038 A~Dの解説 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 040 下から1-4行目 |
|
3刷 | 済 | 1刷 | 2025.02.20 | ||||||
| 043 「A」の上から2-4行目 |
|
3刷 | 済 | 1刷 | 2024.12.26 | ||||||
| 044 「汎化誤差」数式1行目 |
|
2刷 | 済 | 1刷 | 2024.11.15 | ||||||
| 067 大問1小問1選択肢A.~D.の(い) |
|
2刷 | 済 | 1刷 | 2024.11.15 | ||||||
| 072 Bの縦軸の数字 |
|
2刷 | 済 | 1刷 | 2024.11.15 | ||||||
| 074 上から4行目 |
|
3刷 | 済 | 1刷 | 2025.02.25 | ||||||
| 074 選択肢「D」 |
|
3刷 | 済 | 1刷 | 2025.03.06 | ||||||
| 077 「コード3-大問5-3:Tanh」内、下から4-5行目 |
|
3刷 | 済 | 1刷 | 2025.05.28 | ||||||
| 080 小問1正答B.の(い) |
|
2刷 | 済 | 1刷 | 2024.12.10 | ||||||
| 084 小問2正答 |
|
2刷 | 済 | 1刷 | 2024.11.01 | ||||||
| 085 「C」の解説 |
|
3刷 | 済 | 1刷 | 2025.02.20 | ||||||
| 085 「A」の2行目 |
|
3刷 | 済 | 1刷 | 2025.01.08 | ||||||
| 086 上から3行目 |
|
2刷 | 済 | 1刷 | 2024.11.01 | ||||||
| 094 上から3行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 096 正答2行目 |
|
3刷 | 済 | 1刷 | 2025.03.06 | ||||||
| 117 下から7-8行目 |
|
3刷 | 済 | 1刷 | 2025.02.20 | ||||||
| 121 大問9小問3のC.とD.の解説 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 125 上から1行目の数式、「●RMSProp」内の数式の3行目 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 126 RMSPropの数式のうち上から3行目、Adamの数式のうち上から5行目 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 127 上から4行目(数式) |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 140 下から7行目 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 165 HINT 4-5行目 |
|
3刷 | 済 | 1刷 | 2025.02.18 | ||||||
| 166 「転置畳み込み」上から3行目 |
|
3刷 | 済 | 1刷 | 2025.02.19 | ||||||
| 192 上から5行目 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 219 小問3の選択肢「D.」 |
|
3刷 | 済 | 1刷 | 2025.02.27 | ||||||
| 227 大問31小問1の選択肢C. |
|
3刷 | 済 | 1刷 | 2025.05.28 | ||||||
| 229 上から4-5行目 |
|
3刷 | 済 | 1刷 | 2025.03.14 | ||||||
| 231 「D」の解説 |
|
3刷 | 済 | 1刷 | 2025.02.27 | ||||||
| 235 下から4-6行目 |
|
3刷 | 済 | 1刷 | 2025.05.28 | ||||||
| 254 「コード3-大問37-3」の7行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 256 小問3の上から2行目 |
|
2刷 | 済 | 1刷 | 2024.12.03 | ||||||
| 267 「GaussianFilter(ノイズ付与)」の見出し |
|
3刷 | 済 | 1刷 | 2025.02.20 | ||||||
| 302 下から4-5行目 |
|
3刷 | 済 | 1刷 | 2025.03.06 | ||||||
| 313 小問2の正答 |
|
3刷 | 済 | 1刷 | 2025.02.20 | ||||||
| 314 「C」「D」の解説 |
|
3刷 | 済 | 1刷 | 2025.02.20 | ||||||
| 319 YOLOの損失関数の右辺の第一項 |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 320 大問7小問3問題文のB.の(あ)とD.の(あ) |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 321 小問3問題文の1行目 |
|
3刷 | 済 | 1刷 | 2025.02.27 | ||||||
| 321 「A」「B」の(あ)の数式の右辺 |
|
3刷 | 済 | 1刷 | 2025.03.14 | ||||||
| 323 小問4解説 下から2行目 |
|
3刷 | 済 | 1刷 | 2025.02.21 | ||||||
| 323 下から1行目 |
|
3刷 | 済 | 1刷 | 2024.12.26 | ||||||
| 335 YOLOの損失関数の数式右辺の第一項(上から5行目)、B.の解説(下から4行目) |
|
3刷 | 済 | 1刷 | 2026.03.23 | ||||||
| 385 小問3問題文 6行目 |
|
3刷 | 済 | 1刷 | 2025.03.14 | ||||||
| 402 「VAEの目的関数と変分下限」3行目 |
|
3刷 | 済 | 1刷 | 2025.03.14 | ||||||
| 404 上から3行目 |
|
3刷 | 済 | 1刷 | 2025.03.14 | ||||||
| 408 下から3-4行目 |
|
3刷 | 済 | 1刷 | 2025.03.14 | ||||||
| 419 大問23小問1選択肢A.~D.の(あ) |
|
3刷 | 済 | 1刷 | 2025.05.28 | ||||||
| 427 小問2正答:D.の(あ) |
|
3刷 | 済 | 1刷 | 2025.05.28 | ||||||
| 458 [TensorFlow] (あ)の解説 |
|
3刷 | 済 | 1刷 | 2025.02.20 | ||||||
| 459 上から8行目 |
|
3刷 | 済 | 1刷 | 2025.05.28 | ||||||
| DL-155 大問54・68小問1正答(総合問題第6章) |
|
未 | 未 | 1刷 | 2025.03.14 | ||||||
| DL-155 上から7-9行目 |
|
未 | 未 | 1刷 | 2025.03.14 |


.png)